المقدمة
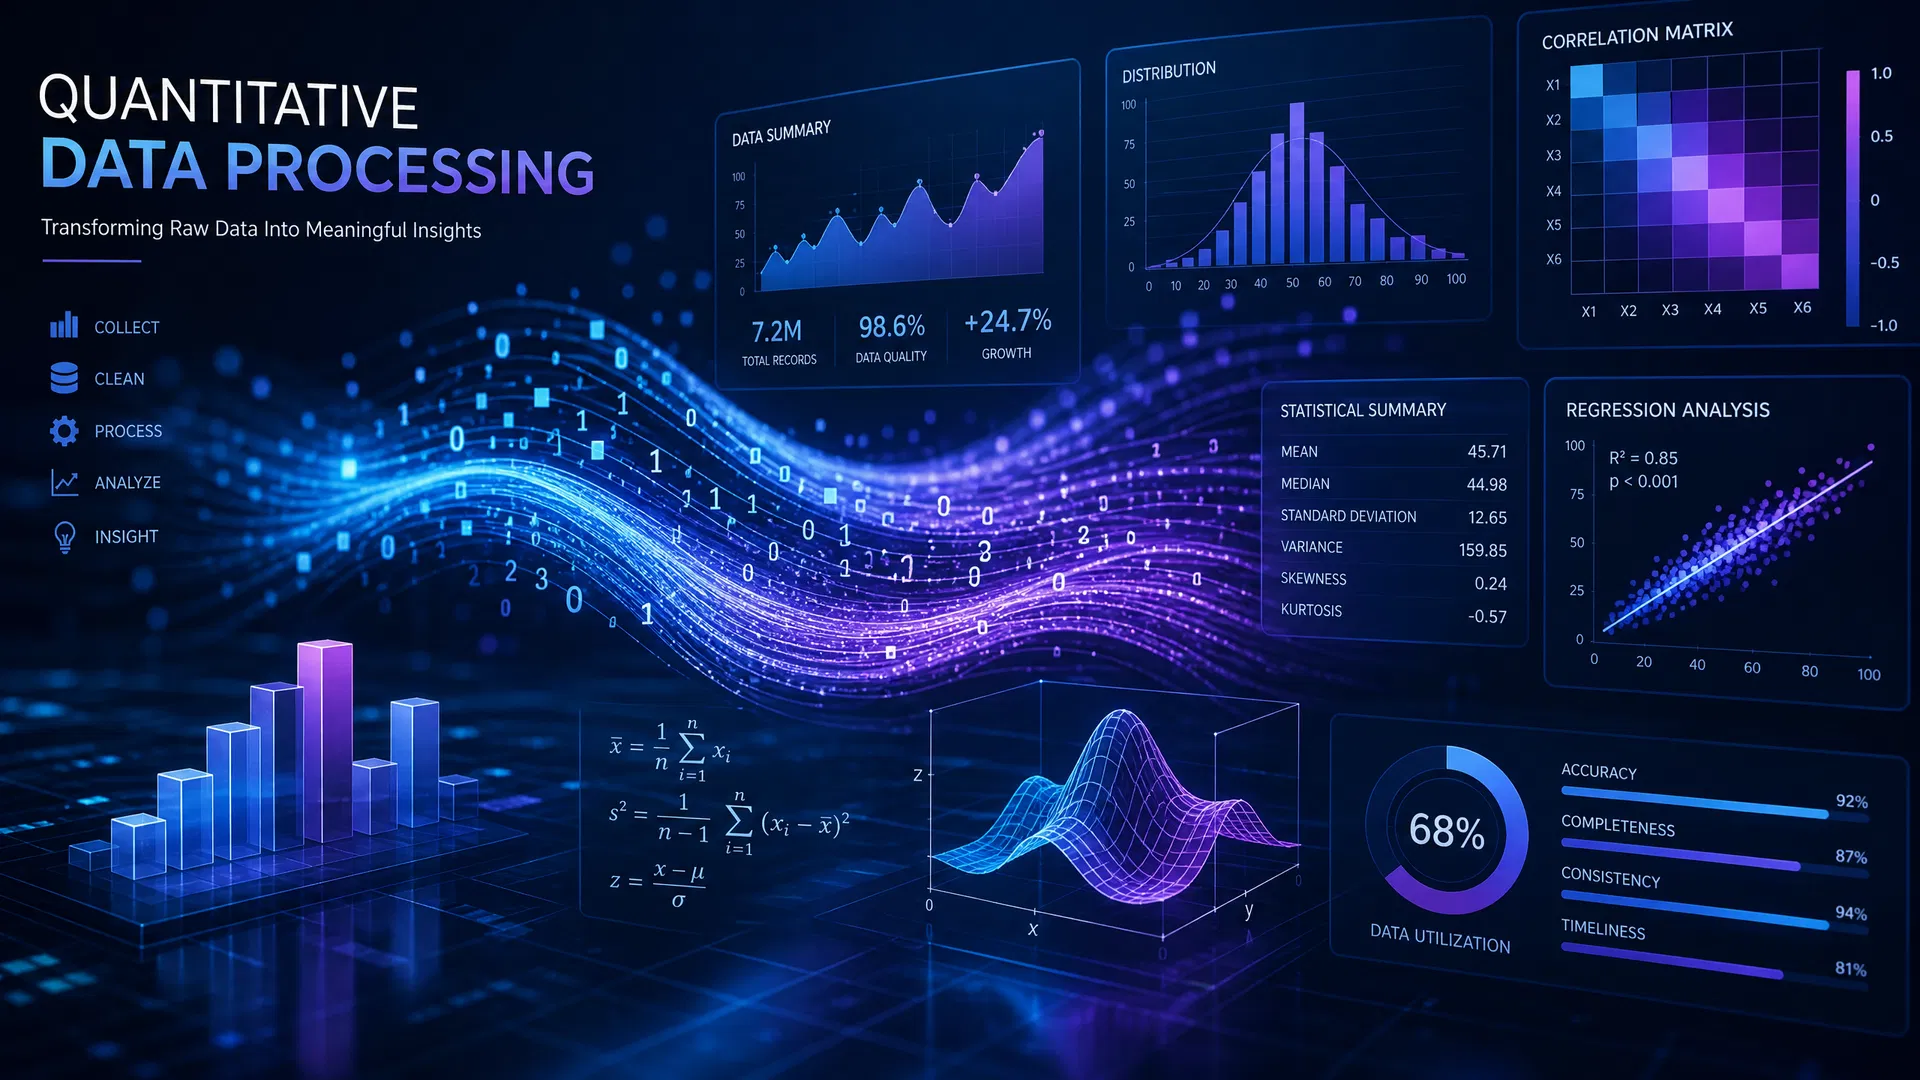
في عصر البيانات الضخمة، أصبحت معالجة البيانات الكمية (Quantitative Data Processing) من أهم المهارات التقنية التي يجب أن يتقنها كل محلل بيانات ومهندس برمجيات. تتعلق هذه العملية بتحويل البيانات الخام غير المنظمة إلى معلومات منظمة وقابلة للتحليل، مما يساعد المؤسسات على اتخاذ قرارات مستنيرة وقائمة على الأدلة.
في هذه المقالة الشاملة، سنستكشف مراحل معالجة البيانات الكمية، والأدوات المستخدمة، والممارسات الفضلى لضمان جودة البيانات والحصول على نتائج دقيقة وموثوقة.
1. ما هي معالجة البيانات الكمية؟
معالجة البيانات الكمية هي عملية منهجية لتجميع وتنظيف وتحليل البيانات الرقمية بهدف استخراج رؤى ذات مغزى. تتضمن هذه العملية عدة خطوات متسلسلة:
المراحل الأساسية:
1.جمع البيانات (Data Collection): تجميع البيانات من مصادر متعددة
2.تنظيف البيانات (Data Cleaning): إزالة الأخطاء والقيم الشاذة
3.معالجة البيانات (Data Processing): تنسيق وتحويل البيانات
4.التحليل الإحصائي (Statistical Analysis): تطبيق الأساليب الإحصائية
5.التصور والإبلاغ (Visualization & Reporting): عرض النتائج بشكل مرئي
2. مرحلة جمع البيانات
تعتبر مرحلة جمع البيانات الخطوة الأولى والحاسمة في أي مشروع تحليل بيانات. يجب أن تكون البيانات المجمعة:
•دقيقة: تعكس الواقع بأمانة
•كاملة: تغطي جميع جوانب الموضوع
•متسقة: موحدة في الصيغة والمعايير
•في الوقت المناسب: محدثة وذات صلة
مصادر جمع البيانات:
المصدر | الوصف | الأمثلة |
قواعد البيانات | مستودعات البيانات المنظمة | MySQL, PostgreSQL, MongoDB |
واجهات برمجية (APIs) | خدمات الويب التي توفر البيانات | Twitter API, Google Analytics |
الملفات | ملفات CSV, JSON, XML | جداول البيانات، السجلات |
أجهزة الاستشعار | أجهزة IoT والمستشعرات | أجهزة قياس درجة الحرارة، الرطوبة |
المسوح والاستبيانات | جمع البيانات من المستخدمين | نماذج الويب، الاستطلاعات |
3. مرحلة تنظيف البيانات
هذه المرحلة تعتبر من أكثر المراحل استهلاكاً للوقت والموارد. يقدر الخبراء أن 80% من وقت محلل البيانات يُصرف على تنظيف البيانات.
المشاكل الشائعة في البيانات:
أ) القيم المفقودة (Missing Values)
Plain Text
الحل الممكن:
- حذف الصفوف التي تحتوي على قيم مفقودة
- ملء القيم المفقودة بالمتوسط أو الوسيط
- استخدام تقنيات التنبؤ المتقدمة
ب) القيم الشاذة (Outliers)
Plain Text
الحل الممكن:
- تحديد القيم الشاذة باستخدام الانحراف المعياري
- إزالة أو تصحيح القيم الشاذة
- استخدام تقنيات الانحدار القوي
ج) البيانات المكررة (Duplicates)
Plain Text
الحل الممكن:
- تحديد الصفوف المكررة
- إزالة النسخ المكررة
- دمج السجلات المتشابهة
د) عدم اتساق الصيغة (Format Inconsistency)
Plain Text
الحل الممكن:
- توحيد صيغة التواريخ
- توحيد وحدات القياس
- تصحيح أخطاء الإملاء والرموز
4. مرحلة معالجة البيانات
بعد تنظيف البيانات، ننتقل إلى معالجتها وتحويلها إلى صيغة قابلة للتحليل.
التقنيات الأساسية:
1. التطبيع (Normalization)تحويل البيانات إلى نطاق موحد (عادة بين 0 و 1):
Plain Text
القيمة المطبعة = (القيمة - الحد الأدنى) / (الحد الأقصى - الحد الأدنى)
2. التوحيد (Standardization)تحويل البيانات بحيث يكون لها متوسط 0 وانحراف معياري 1:
Plain Text
القيمة الموحدة = (القيمة - المتوسط) / الانحراف المعياري
3. تحويل الفئات (Encoding Categorical Data)تحويل البيانات النصية إلى أرقام:
•One-Hot Encoding
•Label Encoding
•Binary Encoding
4. الهندسة الميزانية (Feature Engineering)إنشاء ميزات جديدة من البيانات الموجودة:
Plain Text
مثال: من تاريخ الميلاد → استخراج العمر
من العنوان → استخراج المدينة والدولة
5. التحليل الإحصائي
هذه المرحلة تتضمن تطبيق الأساليب الإحصائية لاستخراج الرؤى من البيانات.
الإحصائيات الوصفية:
المقياس | الصيغة | الفائدة |
المتوسط | Σ(x) / n | قياس النزعة المركزية |
الوسيط | القيمة الوسطى | مقاوم للقيم الشاذة |
الانحراف المعياري | √[Σ(x-μ)²/n] | قياس التشتت |
الارتباط | Cov(x,y) / (σx × σy) | قياس العلاقة بين متغيرين |
الاختبارات الإحصائية:
1. اختبار الفرضيات (Hypothesis Testing)
•اختبار t للعينات المستقلة
•اختبار Chi-Square للاستقلالية
•اختبار ANOVA للمقارنة بين مجموعات
2. تحليل الانحدار (Regression Analysis)
•الانحدار الخطي البسيط
•الانحدار الخطي المتعدد
•الانحدار اللوجستي
3. تحليل التجميع (Cluster Analysis)
•K-Means Clustering
•Hierarchical Clustering
•DBSCAN
6. أدوات معالجة البيانات الكمية
أدوات البرمجة:
Python
Python
import pandas as pd
import numpy as np
from scipy import stats
# تحميل البيانات
df = pd.read_csv('data.csv')
# تنظيف البيانات
df = df.dropna() # حذف القيم المفقودة
df = df[~df.duplicated()] # حذف المكررات
# الإحصائيات الوصفية
print(df.describe())
# التطبيع
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
df_normalized = scaler.fit_transform(df)
R
Plain Text
# تحميل البيانات
data <- read.csv('data.csv')
# الإحصائيات الوصفية
summary(data)
# التطبيع
data_normalized <- scale(data)
# تحليل الارتباط
cor(data)
أدوات متخصصة:
الأداة | الاستخدام | المميزات |
Apache Spark | معالجة البيانات الضخمة | سرعة عالية، معالجة موزعة |
Hadoop | تخزين ومعالجة البيانات | قابلية التوسع، الموثوقية |
Tableau | التصور والإبلاغ | واجهة سهلة، تقارير تفاعلية |
Power BI | تحليل البيانات | تكامل مع Microsoft، رسوم بيانية متقدمة |
SQL | الاستعلام عن البيانات | قوي وسريع، معيار صناعي |
7. الممارسات الفضلى
1. توثيق العملية
•احتفظ بسجل شامل لجميع خطوات المعالجة
•وثق الافتراضات والقرارات المتخذة
•اشرح سبب كل تحويل أو تصفية
2. التحقق من الجودة
•تحقق من صحة البيانات في كل مرحلة
•استخدم الاختبارات الإحصائية للتحقق من الفرضيات
•قارن النتائج مع البيانات الأصلية
3. الأمان والخصوصية
•احم البيانات الحساسة بالتشفير
•التزم بقوانين حماية البيانات (GDPR, CCPA)
•استخدم التجريد لإزالة المعلومات الشخصية
4. الأداء والكفاءة
•استخدم الخوارزميات الفعالة
•قلل من استهلاك الذاكرة
•استفد من المعالجة الموازية
5. التعاون والتواصل
•شارك النتائج بوضوح مع أصحاب المصلحة
•استخدم التصور المرئي لتسهيل الفهم
•اطلب التغذية الراجعة وحسّن العملية
8. دراسة حالة عملية
السيناريو:
شركة تجزئة تريد تحليل بيانات المبيعات لفهم سلوك العملاء وتحسين الإيرادات.
الخطوات:
1. جمع البيانات
•بيانات المبيعات من نظام POS
•بيانات العملاء من قاعدة البيانات
•بيانات المنتجات والفئات
2. تنظيف البيانات
•إزالة المبيعات المرتجعة
•توحيد أسماء المنتجات
•ملء تواريخ المبيعات المفقودة
3. معالجة البيانات
•تجميع المبيعات حسب الفئة والمنطقة
•حساب معدل النمو الشهري
•استخراج ميزات جديدة (موسمية، اتجاهات)
4. التحليل
•حساب متوسط قيمة الطلب
•تحديد المنتجات الأكثر مبيعاً
•تحليل الارتباط بين الفئات
5. النتائج والتوصيات
•زيادة المخزون للمنتجات الموسمية
•تحسين استراتيجية التسعير
•تطوير برامج ولاء العملاء
9. التحديات الشائعة والحلول
التحدي | السبب | الحل |
جودة البيانات الرديئة | مصادر غير موثوقة | التحقق من المصدر، التنظيف الشامل |
البيانات الناقصة | أخطاء في الجمع | الاستكمال الذكي، التنبؤ |
الأداء البطيء | حجم البيانات الكبير | المعالجة الموازية، الفهرسة |
الانحياز في البيانات | عينة غير ممثلة | اختيار عينة عشوائية موازنة |
الإفراط في الملاءمة | نموذج معقد جداً | استخدام التحقق المتقاطع |
10. المستقبل: الذكاء الاصطناعي وتعلم الآلة
مع تطور تقنيات الذكاء الاصطناعي، أصبح من الممكن أتمتة الكثير من مراحل معالجة البيانات:
•التعلم الآلي: تدريب نماذج على البيانات التاريخية للتنبؤ بالمستقبل
•معالجة اللغة الطبيعية: استخراج الرؤى من البيانات النصية
•الشبكات العصبية: معالجة البيانات المعقدة والعلاقات غير الخطية
•التعلم العميق: فهم الأنماط المعقدة في البيانات الضخمة
الخلاصة
معالجة البيانات الكمية ليست مجرد عملية تقنية، بل هي فن وعلم يتطلب فهماً عميقاً للإحصائيات والبرمجة والمجال المتخصص. من خلال اتباع الخطوات المنهجية والممارسات الفضلى، يمكننا تحويل البيانات الخام إلى رؤى قيمة تدفع القرارات الاستراتيجية.
في عالم يتسارع نحو الرقمنة، فإن القدرة على معالجة البيانات الكمية بفعالية أصبحت مهارة حاسمة للنجاح في أي مجال. سواء كنت محلل بيانات أو مهندس برمجيات أو صانع قرار، فإن فهم هذه العملية سيساعدك على اتخاذ قرارات أفضل وتحقيق نتائج أكثر دقة وموثوقية.
إرسال تعليق